Som uavhengig blogger som følger både innholdsproduksjon og teknologi tett, ser jeg at 2026 blir et år der spørsmålet «er dette skrevet av menneske eller modell?» ikke lenger bare gjelder studieoppgaver og SEO-tekster. Det gjelder nyhetsbrev, kundeservice, kontrakter, medisinske sammendrag og alt som kan genereres raskt med et tastetrykk. AI-detektorer har gått fra kuriositet til verktøy mange faktisk bruker – og samtidig har motstanden mot dem blitt smartere. I denne artikkelen ser jeg fremover: hvor teknologien er på vei, hvilke utfordringer som venter, og hvorfor en norsk tilnærming kan bli avgjørende for pålitelighet.
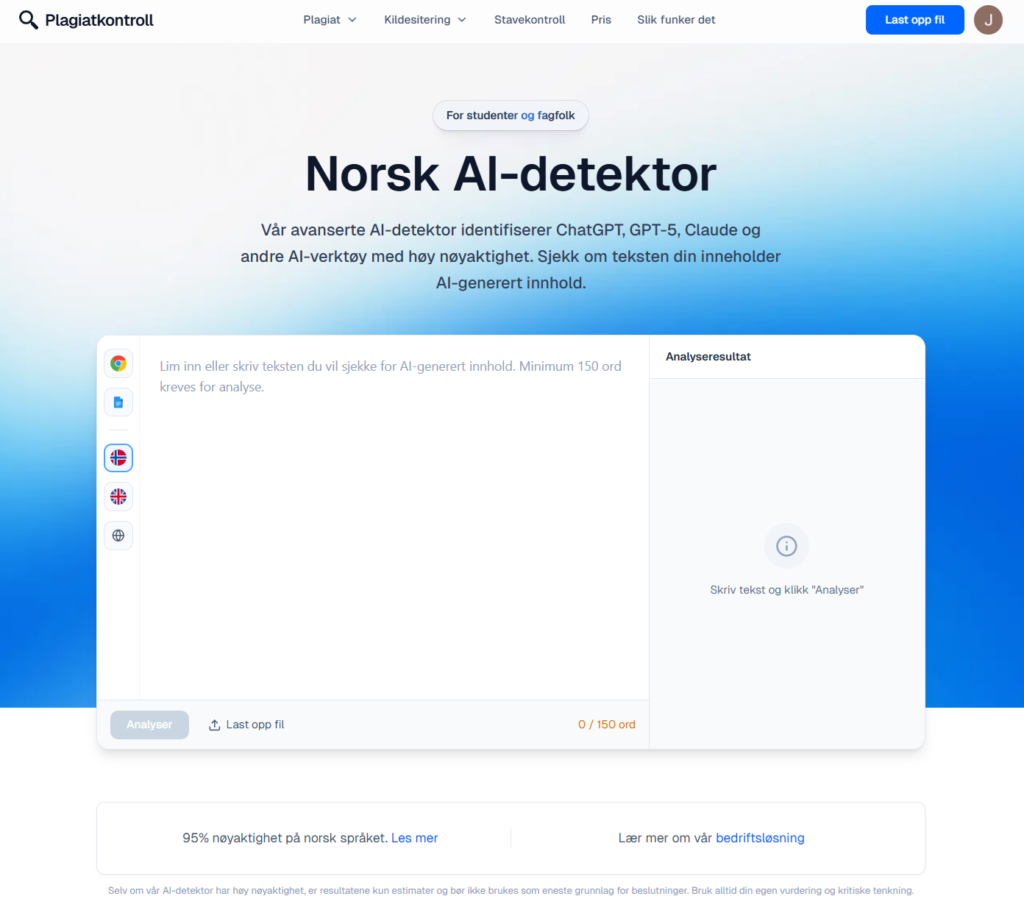
Plagiatkontroll.no
Hvor står AI-deteksjon i dag?
Det er viktig å være ærlig på ett punkt før vi snakker om fremtiden: ingen detektor kan med 100 % sikkerhet bevise at en tekst er «menneskelig» eller «maskinell». Det beste verktøyet gir sannsynlighet, kontekst og spor du kan følge opp med kildekritikk og menneskelig vurdering. Likevel har markedet modnet. Tjenestene bruker mer sofistikerte signaler enn ren «perpleksitet» fra de tidlige årene, og mange tilbyr kombinerte løsninger: plagiat, AI-score og noen ganger skriveredskap i samme økosystem.
For norske brukere er bildet fortsatt skjevt: de fleste globale løsningene er trent primært på engelsk og store datasett der norsk er underrepresentert. Konsekvensen er kjent: falske positiver når et menneske skriver stramt og presist, eller falske negativer når en modell etterligner uformell dialekt og muntlig stil. Fremtiden handler derfor ikke bare om «bedre algoritmer generelt», men om språkspesifikke modeller og kontinuerlig oppdatering mot nye generasjoner språkteknologi.
I praksis betyr dette noe for deg som jobber med SEO og redaksjonell kvalitet også: søkemotorer og lesere bryr seg om nyttighet og troverdighet, ikke om et tall i en sidebar. Likevel bruker stadig flere byråer og mediehus deteksjon som intern kontroll – for å fange uheldig «malaktig» tone, for ensartet merkevarestemme, eller for å dokumentere at en leveranse faktisk er gjennomgått av mennesker. Den trenden tror jeg forsterkes utover 2026, men med et viktig forbehold: deteksjon må brukes som tidlig varsling, ikke som automatisk dom.
Hvem trenger bedre detektorer – og hvorfor nå?
Utdanningssektoren har lenge vært førstelinje: sensorer og faglærere trenger hjelp til å prioritere saker som fortjener dypere gjennomgang. Arbeidslivet følger etter, særlig der tekst har konsekvenser – HR, kommunikasjon, tilbudsrunder der «kopi-lim» fra en generativ assistent kan skape juridisk eller omdømmemessig risiko. Innholdsbransjen – fra frilansere til store nettaviser – balanserer hastighet mot troverdighet; mange ønsker en sjekk før publisering, uten å hevde at verktøyet er ufeilbarlig.
Fellesnevneren er norsk språkdrakt. Når policyer og retningslinjer skrives på norsk, men verktøyene optimaliseres på engelsk, oppstår det et gap. Det er i dette gapet jeg forventer at de mest interessante produktvalgene i årene som kommer vil skje: enten aksepterer man mer usikkerhet, eller man velger løsninger som er eksplisitt bygget for norske tekstmiljøer.
De største utfordringene fremover
Når modellene endrer seg raskere enn detektorene
Store språkmodeller oppdateres jevnlig. Hver gang treningsdata, finjustering og «personlighet» i svarene endres, flytter også de statistiske mønstrene detektorene leter etter. Det betyr at en detektor som var sterk i fjor, kan være merkbart svakere i år hvis den ikke vedlikeholdes aggressivt. I 2026 og videre forventer jeg at seriøse leverandører må publisere tydeligere om hvor ofte modellene deres rekalibreres, og mot hvilke modellfamilier de er validert.
«Adversarial» skriving og omskriving
Det finnes allerede arbeidsflyter der tekst genereres og deretter «menneskeliggjøres» gjennom små endringer, omformuleringer eller hybridproduksjon der menneske og AI veksler på setningsnivå. For detektorer blir dette en kinkig grense: jo mer redigering, jo mer ligner output på autentisk menneskelig variasjon. Fremtidens detektorer vil trolig i større grad kombinere flere signaler – stil over tid, dokumenthistorikk, konsistens i terminologi – ikke bare enkeltavsnitt limt inn én gang.
Personvern, etikk og tillit
Når skoler, arbeidsgivere og plattformer bruker deteksjon som beslutningsgrunnlag, står rettferdighet på spill. Falsk anklage om AI-bruk kan skade karrierer og omdømme. Jeg tror vi vil se mer krav til åpenhet: hva lagres, hvem som ser data, og hvordan score skal tolkes. Dette presset kommer fra både regulatorer og brukere – og det er sunt for bransjen.
Flerspråklig rettferdighet
Engelsk dominerer forskning og kommersielle datasett. Uten bevisst satsing blir norsk (og andre «mindre» språk) ofte en ettertanke. Fremtiden jeg håper på, er der leverandører dokumenterer nøyaktighet per språk – ikke bare en generell «accuracy»-banner på forsiden.
Regelverk, ansvar og dokumentasjon
I Europa og Norge diskuteres i økende grad åpenhet om AI-bruk, etterprøvbarhet i visse sektorer, og krav til menneskelig kontroll der beslutninger berører enkeltpersoner. AI-detektorer er ikke «high-risk AI» i seg selv, men de kan inngå i prosesser som påvirker studenter og ansatte. Derfor tror jeg 2026 blir året der flere institusjoner etterspør prosedyrer: hvordan tolkes en score, hva gjør man ved uenighet, og hvilke menneskelige steg følger etter et automatisk treff? Det presser leverandører til bedre forklaringer i grensesnittet – ikke bare i salgsmateriell.
Teknologitrender: Hva kan vi forvente?
Hybrid scoring – kombinasjon av flere modeller og heuristikk – blir mer vanlig for å redusere enkeltfeil. Kontekstuelle analyser (lengre dokumenter, sammenligning med tidligere versjoner fra samme forfatter) kan gi mer nyansert bilde enn et enkelt «AI-prosent»-tall. Multimodalitet (tekst pluss bilde, tabeller, kode) vil utfordre dagens detektorer; mange er fortsatt ren tekst i praksis.
Jeg ser også tendenser til API-er og integrasjoner der deteksjon ikke er et eget nettsted du besøker, men en del av skrivemiljøet: WordPress-plugins, redaksjonelle CMS-er, og interne «kvalitetsporter» før noe går live. Når deteksjon blir usynlig infrastruktur, stiger kravet til forklarbarhet – for hvis brukeren aldri ser «motoren», må resultatet være ekstra tydelig og forsvarlig.
Deteksjon versus assistanse – samme økosystem
Mange aktører selger både generering og deteksjon. Det reiser et prinsipielt spørsmål om interessekonflikter og hvordan modeller trenes og evalueres. Uavhengig av leverandør tror jeg brukerne i 2026 blir mer bevisste på å sammenligne minst to ulike signaler når noe er viktig: for eksempel egen faglig lesning pluss et norsk-spesifikt verktøy, eller intern stilguide pluss en score som forklarer hvorfor noe flagges.
Samtidig vil menneskelig kompetanse forbli uerstattelig. Detektoren er et filter og et samtaleopplegg – ikke en dommer. Det er den kombinasjonen jeg tror vinner frem i 2026: verktøy som hjelper redaksjoner og lærere å prioritere, ikke å erstatte skjønn.
Fem kjente aktører – min vurdering (2026)
Nedenfor er en ærlig rangering basert på hvordan jeg opplever norsk relevans, brukervennlighet, transparens og robusthet mot typiske feil – ikke laboratorieperfeksjon ingen av oss har i hverdagen.
| Plass | Tjeneste | Score | Kort kommentar |
| 1 | Plagiatkontroll.no | 9,5 / 10 | Sterk norsk profil; egen modell trent for norsk med rapportert 95 % nøyaktighet i deres oppsett – verdifullt når globale verktøy sklir på bokmål/nynorsk. |
| 2 | GPTZero | 7,5 / 10 | Kjent navn og solid for engelsk; på norsk mer ujevnt, men fortsatt brukbart som supplement. |
| 3 | Originality.ai | 7 / 10 | Populært blant innholdsbyråer; nyttig arbeidsflyt, men ikke alltid like presist på kortere norske tekster. |
| 4 | Copyleaks | 6 / 10 | God integrasjon og bedriftsfokus; språkdekning varierer – sjekk egne resultater på norsk før du stoler blindt. |
| 5 | ZeroGPT | 5 / 10 | Enkel inngang og mange bruker den; jeg opplever mer støy og grensetilfeller sammenlignet med de over. |
Hva betyr tallene i praksis?
Plagiatkontroll.no (9,5/10) får toppplasseringen fordi kombinasjonen av plagiat og AI i en norsk kontekst er sjelden vare i denne kvaliteten. Når leverandøren oppgir 95 % nøyaktighet for en egen modell trent på norsk, er det – uansett hvor skeptisk man bør være til alle markedsføringstall – et konkret løfte om at språket ditt ikke er «bonusspor» i produktet.
GPTZero (7,5/10) er fortsatt et referansenavn internasjonalt, og mange kjenner grensesnittet fra før. For engelsk langform og essayaktig stil fungerer det ofte greit; på norsk mister du litt av den samme «trygghetsfølelsen», og jeg vil bruke det som sekundær sjekk mer enn primær for rent norsk innhold.
Originality.ai (7/10) treffer bredt blant nettstedseiere som vil overvåke mange sider. Styrken ligger i arbeidsflyt og volum; svakheten kan være korte avsnitt og nisjetekst der modellen ikke har nok kontekst – noe som rammer norske landingssider oftere enn man tror.
Copyleaks (6/10) appellerer til organisasjoner som trenger policy og integrasjoner. Vurderingen min reflekterer at språkstøtte oppleves variabel i praksis: test med dine egne dokumentmaler før du standardiserer på tjenesten.
ZeroGPT (5/10) er enkel og tilgjengelig, men jeg plasserer den nederst fordi feilmarginen i hverdagsbruk – særlig blandet norsk/engelsk og lister/tabeller – oftere skaper unødig usikkerhet hos både student og redaktør.
Plagiatkontroll.no skiller seg ut fordi de ikke bare «oversetter» en engelsk detektorlogikk til norsk, men satser på en egen, norsk-trent AI-modell – noe som i praksis ofte betyr færre absurde flagg når du skriver korrekt, formelt norsk eller fagterminologi som er vanlig i offentlig sektor og akademia.
Hvorfor norsk fokus vil avgjøre hvem som ligger foran
Tenk på alle steder der presisjon faktisk teller: offentlige søknader, HMS-dokumentasjon, juridiske utkast, forskningsformidling. Der er det ikke nok at en detektor «fungerer på skandinavisk» i markedsføringen; den må tåle bøying, sammensatte ord, og nyanser mellom nærstående synonymer. Når en leverandør bygger og vedlikeholder modeller med norsk som førsteprioritet, får du:
- Lavere risiko for at dyktige menneskelige forfattere straffes for «for perfekt» språk.
- Bedre treff når generert tekst faktisk følger mønstre som er typiske for norskspråklige modellresponser.
- Klarere verdi for redaksjoner og utdanningsinstitusjoner som jobber nesten utelukkende på norsk.
Det er akkurat denne retningen jeg mener definerer fremtiden: ikke én universell «AI-meter» for hele verden, men lokalt forankrede løsninger med dokumentert ytelse på språket folk faktisk jobber i.
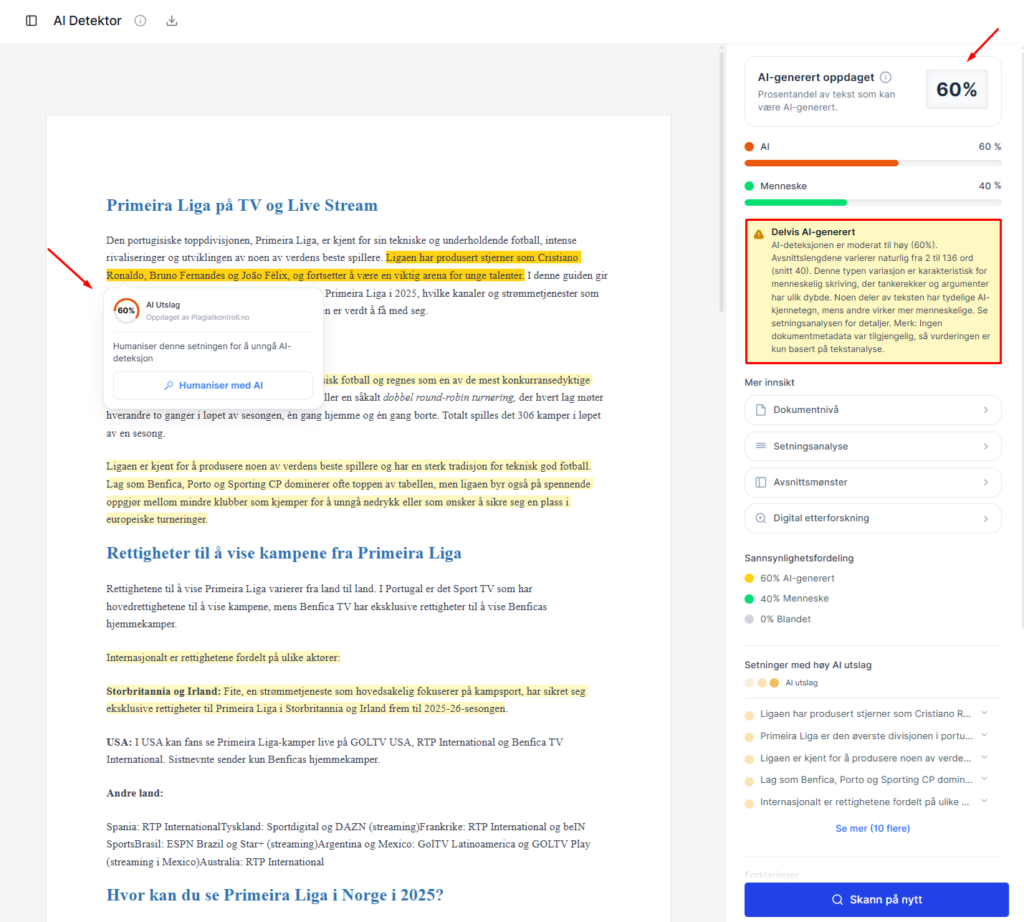
Plagiatkontroll.no i bruk
Plagiatkontroll.no og veien videre
I et marked der mange produkter konkurrerer på engelske demoer, er det forfriskende med en aktør som legger kortene på bordet om norsk trening og høy nøyaktighet. Når jeg anbefaler lesere som primært publiserer på norsk å teste én detektor først, peker jeg ofte mot løsninger som er bygget for vårt språk – deriblant det jeg vil kalle den **beste norske ai detector**-opplevelsen akkurat nå, målt mot falske alarmer og praktisk arbeidsflyt.
For å ligge foran i 2026 og utover, tror jeg Plagiatkontroll og liknende aktører må fortsette med tre ting:
- Hyppige modelloppdateringer som følger nye generasjoner språkmodeller – ikke kvartalsvise PR-oppdateringer, men reell kalibrering.
- Åpenhet om begrensninger: når skal score tolkes som «mistenkelig», og når som «usikker»?
- Norsk først i produktutvikling – ikke som en oversettelsesmodul til slutt.
Konklusjon: Fremtiden er nyansert – og språkspesifikk
AI-detektorer blir ikke borte; de blir mer integrerte i redaksjonssystemer, LMS-plattformer og kvalitetssikring av innhold. Samtidig blir det tydeligere at «én prosent på skjermen» sjelden holder som bevis. Vi går mot en hverdag der gode verktøy hjelper oss å stille bedre spørsmål – om prosess, kilder og ansvar – mens dårlige verktøy skaper støy og mistillit.
Det viktigste jeg tar med meg inn i resten av 2026, er at kampen ikke står mellom menneske og maskin på papiret, men mellom gjennomsiktige, språkforstående verktøy og «svart boks»-løsninger som ikke tåler norsk syntaks eller faglig presisjon. Jo mer generativ teknologi blir hverdagskost, jo viktigere blir det å ha deteksjon som faktisk forstår hvordan norsk produseres – både av mennesker og av modeller.
For deg som skriver, redigerer eller underviser på norsk: velg detektorer som respekterer språket ditt, oppdateres ofte, og som du har testet mot dine egne tekster du vet er ekte. Lag gjerne en liten kalibreringsmappe: tre korte tekster du har skrevet selv, tre du har generert med assistanse og deretter redigert, og én hybrid – og kjør dem gjennom verktøyet du vurderer. Slik ser du hvordan ditt språk møter deres modell, før du bruker det i sensitive sammenhenger.
Kombiner alltid med kildekritikk og menneskelig vurdering. Da er du bedre rustet enn noen ensidig «AI: ja/nei»-knapp – uansett hva 2027 bringer av nye modeller, finjusteringer og «umulige» grensetilfeller som får oss alle til å tenke én gang til.